'/%3e%3c/svg%3e) 发布
;}.c{fill:%233f3f3f;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='24'%20height='24'%20transform='translate(0%20-0.256)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20transform='translate(0%200.256)'%3e%3cg%20class='b'%3e%3cpath%20class='c'%20d='M12.938,13.58a.745.745,0,0,1-.328-.076L4.549,9.523a.741.741,0,0,1,0-1.33L12.61,4.212a.74.74,0,0,1,.657,0l8.061,3.981a.741.741,0,0,1,0,1.33L13.267,13.5a.741.741,0,0,1-.329.076M6.553,8.858l6.385,3.153,6.386-3.153L12.938,5.705Z'%20transform='translate(-1.067%20-1.067)'/%3e%3cpath%20class='c'%20d='M12.939,20.964a.729.729,0,0,1-.328-.077l-8.062-3.98a.742.742,0,1,1,.657-1.33l7.733,3.818,7.733-3.818a.742.742,0,1,1,.657,1.33l-8.062,3.98a.729.729,0,0,1-.328.077'%20transform='translate(-1.067%20-3.999)'/%3e%3cpath%20class='c'%20d='M12.939,26.964a.729.729,0,0,1-.328-.077l-8.062-3.98a.742.742,0,1,1,.657-1.33l7.733,3.818,7.733-3.818a.742.742,0,1,1,.657,1.33l-8.062,3.98a.729.729,0,0,1-.328.077'%20transform='translate(-1.067%20-5.547)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
;}.c{fill:%233f3f3f;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='24'%20height='24'%20transform='translate(0%200.225)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20transform='translate(0%20-0.225)'%3e%3cg%20class='b'%3e%3cpath%20class='c'%20d='M21.648,9.056a.754.754,0,0,0-.215-.535l-5.3-5.3a.752.752,0,0,0-.535-.215V3H7.375A2.377,2.377,0,0,0,5,5.376V20.307a2.377,2.377,0,0,0,2.375,2.376h11.9a2.378,2.378,0,0,0,2.376-2.376V9.056ZM16.355,5.584,19.07,8.3H16.923a.569.569,0,0,1-.568-.568Zm2.924,15.584H7.375a.862.862,0,0,1-.861-.861V5.376a.862.862,0,0,1,.861-.861h7.466V7.731a2.084,2.084,0,0,0,2.082,2.082H20.14V20.307a.863.863,0,0,1-.861.861'%20transform='translate(-1.215%20-0.729)'/%3e%3cpath%20class='c'%20d='M10.757,15.514H15.3A.757.757,0,0,0,15.3,14H10.757a.757.757,0,0,0,0,1.514'%20transform='translate(-2.43%20-3.402)'/%3e%3cpath%20class='c'%20d='M18.327,20h-7.57a.757.757,0,0,0,0,1.514h7.57a.757.757,0,0,0,0-1.514'%20transform='translate(-2.43%20-4.86)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
原创 【进迭时空 K1 MUSE Pi Pro】YOLO26 部署测试
本文介绍了进迭时空 K1 MUSE Pi Pro 开发板结合 OpenCV 和 Ultralytics 库实现 YOLO26 板端部署,并实现目标识别、姿态估计、图像分割、图像分类、旋转框检测的项目设计,包括环境部署、模型获取、关键代码、效果演示等。
 无垠的广袤
0107

本文介绍了进迭时空 K1 MUSE Pi Pro 开发板结合 OpenCV 和 Ultralytics 库实现 YOLO26 板端部署,并实现目标识别、姿态估计、图像分割、图像分类、旋转框检测的项目设计,包括环境部署、模型获取、关键代码、效果演示等。
无垠的广袤
本文介绍了进迭时空 K1 MUSE Pi Pro 开发板的相关信息,包括参数特点、资源配置、系统框图等,进一步连接外设开机进入系统,SSH 远程登陆。
无垠的广袤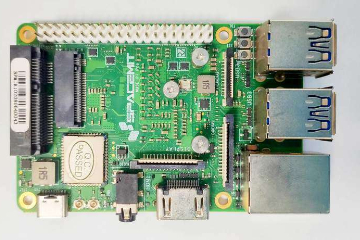
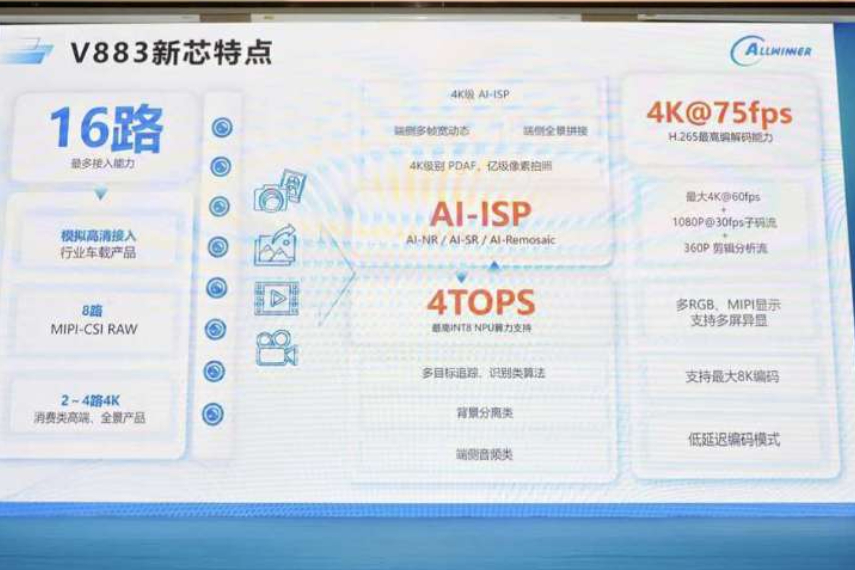
7月23日,在2026全志科技「智慧视界」生态创新大会上,全志科技带来了V881处理器和Agent解决方案,还宣布了V883的上市时间和产品细节。让人眼前一亮的是,在全志的方案平台上,一个AI视觉产品的开发周期,已经相比过去缩短过半。
 章鹰观察
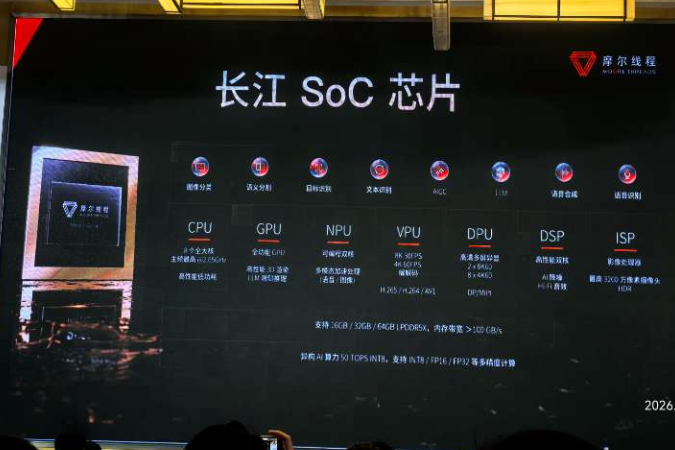
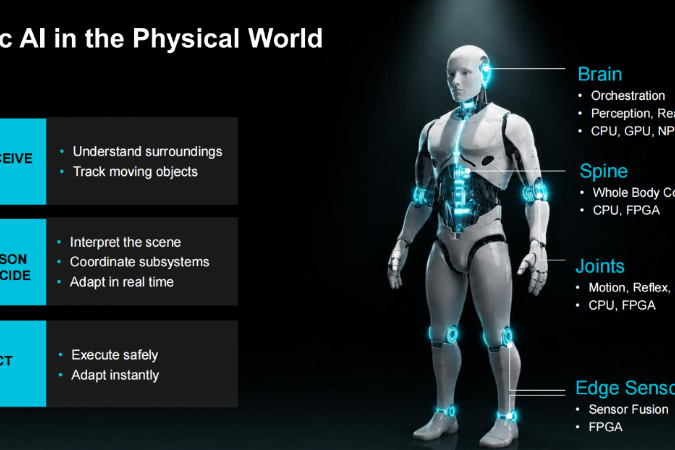
近期项目国产化替代需求激增,从工业控制、安防 IPC、具身机器人到车载域控、物联网网关,市面上国产开发板型号爆发式增长:玄铁、瑞芯微、地平线、飞凌、触觉智能、赛昉、地瓜机器人、涂鸦 Tuya、纳芯微、六岳微、匠芯创、富瀚微、进迭时空、飞腾等几十家厂商均推出完整评估套件,但选型、移植、量产踩坑问题层出不穷,今天开帖和大家深度交流选型逻辑、实际落地痛点,欢迎结合项目经验留言分享!
 CNC老兵
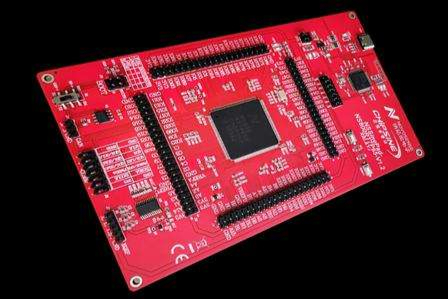
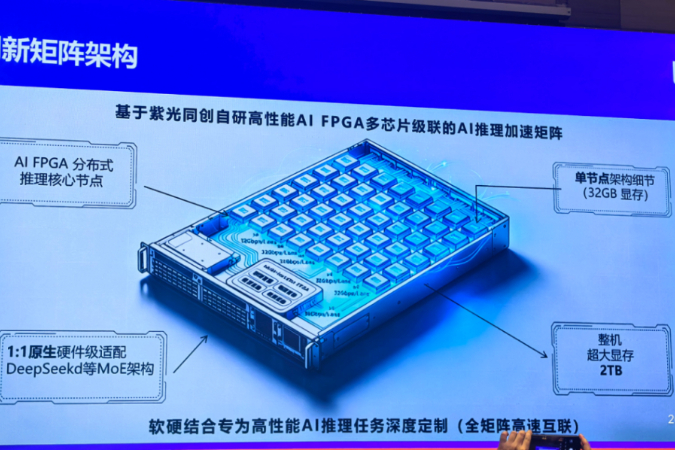
NS800RTP65D(S)系列是纳芯微(NSSine™)基于 ARM Cortex®-M7 内核推出的一款实时微控制器。该系 列融合了数字信号处理与微控制器两大优势,为纳芯微的最新研发成果。 本产品搭载两个 ARM Cortex®-M7 内核。该内核基于 ARMv7E-M 架构,集成双精度浮点单元(FPU),符 合 IEEE 754 标准;内置 DSP 扩展指令集,支持单周期 16/32 位 M
jf_26932943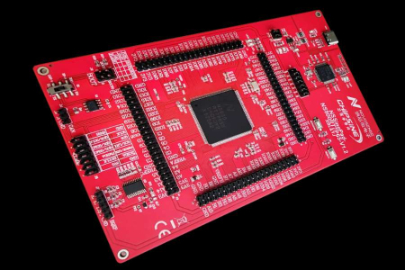
7月19日,在WAIC大会上,端侧AI SoC芯片领先厂商瑞芯微展出了RK35xx主控+RK1828端侧AI协处理器双芯协同方案。瑞芯微RK82X产品负责人杨凯对媒体表示,此次瑞芯微展示了八大可落地的端侧AI方案,包括AI NAS, AI NVR, 车载AI Box以及大屏类的应用、音频模型应用和视频模型应用,智能体应用和机器人应用。
章鹰观察
我们正处于万物互联,万物智能全面普及的时代,厂商只做硬件或者芯片是不够的,更需要我们打造一套完整、开放和落地的底层创新生态。7月16日,在深圳举办的AIoT生态技术大会上,兆易创新MCU事业部负责人闫雪璐发表了《构筑芯片之上的创新生态,开放共建助力智能升级》的演讲。
章鹰观察

华秋开源硬件社区,为你的创意买单!活动以 “用T5,让AI硬件触手可及”为主题,倡导开发者充分利用T5开发板的语音交互、屏幕显示、AI推理等核心能力,结合Vibe Coding等AI辅助编程工具,降低AI硬件开发门槛,加速创意落地。
 dianzi_0101


和高校课堂教材重数学推导、轻实际调试的写作模式不同,本书完全贴合硬件工程师成长路线划分章节,搭建起从零基础入门到工业项目落地的完整学习链路,本书最大特色是脱离纯理论学院派写作,每一章都融入作者多年一线开发踩坑经验,将理论公式、电路原理图、仿真波形、故障排查流程融为一体,同时兼具教材、器件手册、项目案例库三重作用,兼顾在校学习、竞赛开发与职场项目开发多重需求。为此,我写下了这篇读书报告。
jf_09482071
7月1日到3日,安路科技亮相上海慕尼黑电子展,在AI视觉与边缘计算,汽车电子和数据中心都有精彩产品亮相,本次重点推荐的有SALELF系列FPGA,面向数据中心和服务器。ELF系列FPGA定位低功耗可编程市场,采用先进的55nm低功耗工艺制造,是目前国产低功耗小容量可编程器件中容量密度领先的产品。
章鹰观察

7月8日,三星电子宣布实现PM1763的量产,这是该公司基于PCle6.0的企业级固态硬盘,是三星专为英伟达Vera Rubin AI算力平台打造的。与上一代产品PM1753相比,PM1763的顺序读写速度实现倍增,以16TB版本为例,其顺序读写速度达每秒28400MB,顺序写入速度达到每秒21900MB。这种速度意味着,传输一个40GB的大型语言模型仅需要1.4秒(以 Meta Llama-37
章鹰观察
;}.c{fill:%23555;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='18'%20height='18'%20transform='translate(1543%202144)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20class='b'%20transform='translate(-1543%20-2144)'%3e%3cpath%20class='c'%20d='M182.144,108.918a.7.7,0,1,1-1.407,0V98.083l-.033.027-.054.05-5.045,5.045a.7.7,0,0,1-1.041-.945l.046-.05,5.045-5.045a2.508,2.508,0,0,1,3.477-.031l.075.072,4.988,5.022a.7.7,0,0,1-.949,1.038l-.05-.046L182.21,98.2l-.066-.061Zm5.394-15.827a.7.7,0,1,1,0,1.407h-12.2a.7.7,0,1,1,0-1.407Z'%20transform='translate(1370.601%202051.909)'/%3e%3c/g%3e%3c/svg%3e "回到顶部")