


'/%3e%3c/svg%3e) 发布
;}.c{fill:%233f3f3f;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='24'%20height='24'%20transform='translate(0%20-0.256)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20transform='translate(0%200.256)'%3e%3cg%20class='b'%3e%3cpath%20class='c'%20d='M12.938,13.58a.745.745,0,0,1-.328-.076L4.549,9.523a.741.741,0,0,1,0-1.33L12.61,4.212a.74.74,0,0,1,.657,0l8.061,3.981a.741.741,0,0,1,0,1.33L13.267,13.5a.741.741,0,0,1-.329.076M6.553,8.858l6.385,3.153,6.386-3.153L12.938,5.705Z'%20transform='translate(-1.067%20-1.067)'/%3e%3cpath%20class='c'%20d='M12.939,20.964a.729.729,0,0,1-.328-.077l-8.062-3.98a.742.742,0,1,1,.657-1.33l7.733,3.818,7.733-3.818a.742.742,0,1,1,.657,1.33l-8.062,3.98a.729.729,0,0,1-.328.077'%20transform='translate(-1.067%20-3.999)'/%3e%3cpath%20class='c'%20d='M12.939,26.964a.729.729,0,0,1-.328-.077l-8.062-3.98a.742.742,0,1,1,.657-1.33l7.733,3.818,7.733-3.818a.742.742,0,1,1,.657,1.33l-8.062,3.98a.729.729,0,0,1-.328.077'%20transform='translate(-1.067%20-5.547)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
;}.c{fill:%233f3f3f;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='24'%20height='24'%20transform='translate(0%200.225)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20transform='translate(0%20-0.225)'%3e%3cg%20class='b'%3e%3cpath%20class='c'%20d='M21.648,9.056a.754.754,0,0,0-.215-.535l-5.3-5.3a.752.752,0,0,0-.535-.215V3H7.375A2.377,2.377,0,0,0,5,5.376V20.307a2.377,2.377,0,0,0,2.375,2.376h11.9a2.378,2.378,0,0,0,2.376-2.376V9.056ZM16.355,5.584,19.07,8.3H16.923a.569.569,0,0,1-.568-.568Zm2.924,15.584H7.375a.862.862,0,0,1-.861-.861V5.376a.862.862,0,0,1,.861-.861h7.466V7.731a2.084,2.084,0,0,0,2.082,2.082H20.14V20.307a.863.863,0,0,1-.861.861'%20transform='translate(-1.215%20-0.729)'/%3e%3cpath%20class='c'%20d='M10.757,15.514H15.3A.757.757,0,0,0,15.3,14H10.757a.757.757,0,0,0,0,1.514'%20transform='translate(-2.43%20-3.402)'/%3e%3cpath%20class='c'%20d='M18.327,20h-7.57a.757.757,0,0,0,0,1.514h7.57a.757.757,0,0,0,0-1.514'%20transform='translate(-2.43%20-4.86)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
;}.cls-3{fill:%23dbdbdb;}.cls-4{stroke:%23333;stroke-miterlimit:10;stroke-width:0.5px;}%3c/style%3e%3cclipPath%20id='clip-path'%3e%3crect%20class='cls-1'%20width='22'%20height='22'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20class='cls-2'%3e%3cpath%20class='cls-3'%20d='M16.89,7.8s-1,4.28-4,6a21,21,0,0,1-6.55,1.66,9.87,9.87,0,0,0,6.38,1c3.47-.72,6.82-4.66,6.71-5.43A5.88,5.88,0,0,0,17.6,8.17,2.76,2.76,0,0,0,16.89,7.8Z'/%3e%3cellipse%20class='cls-4'%20cx='11'%20cy='10.94'%20rx='8.53'%20ry='5.49'/%3e%3ccircle%20class='cls-4'%20cx='11'%20cy='10.94'%20r='2.49'/%3e%3c/g%3e%3c/svg%3e)
近日,中科曙光联合西安交通大学科研团队,依托全国产十万卡AI超集群曙光8000,完成超大规模33喷口超声速射流高精度数值模拟,计算网格规模达到6.774万亿单元,创下国际已知最大规模的同类仿真纪录。模拟复现了多股尾焰交汇、干扰与混合的复杂过程,相当于为发动机群尾焰做了一次“超高清CT扫描”,让难以直接观察的流动细节变得可分析、可研究。
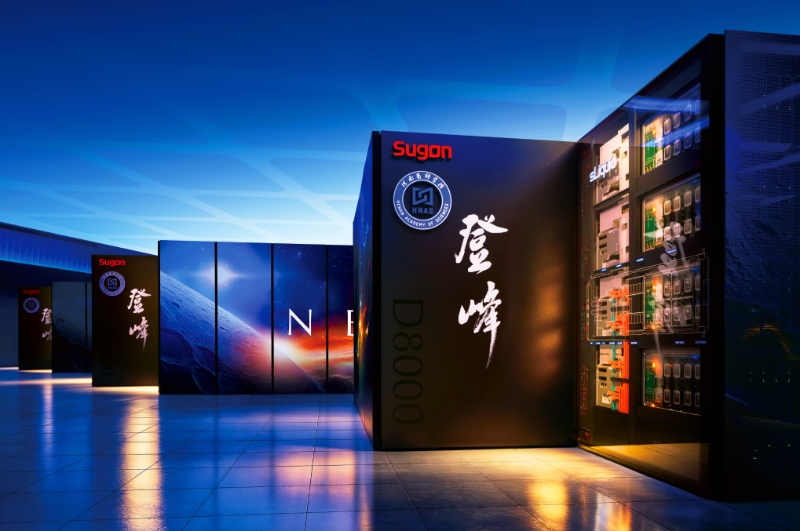
成果面向商业航天可重复使用火箭研究,为结构安全评估与防热设计提供了高精度计算手段,展现了国产算力支撑前沿工程科学研究的能力。
可重复使用火箭33台发动机并联设计的风险考量
西安交通大学航天航空学院教授、博导,陕西省先进飞行器服役环境与控制重点实验室副主任姬兴分析,可重复使用火箭(如回收后再发射的火箭)通常采用多台发动机并联设计。发动机一多,各台发动机喷出的超声速尾焰(高温高速气流)就会在火箭尾部互相碰撞、干扰,产生复杂的激波和湍流。
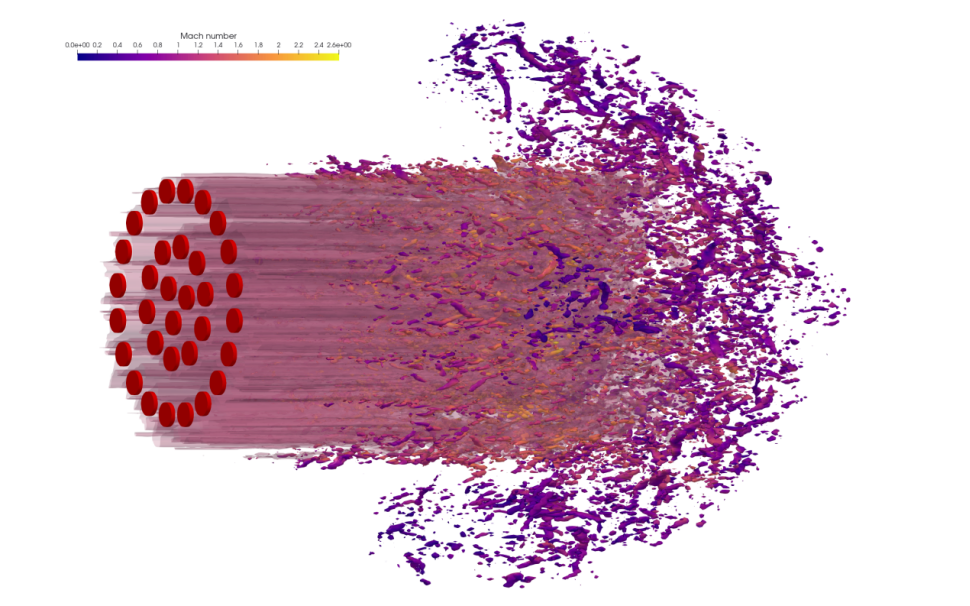
火箭33个尾喷流高速喷射时产生强烈的相互耦合干扰,带来两大核心风险,严重威胁火箭结构安全。
一是动态振动风险,多股射流相互挤压扰动,会产生持续、随时间剧烈变化的不对称推力,引发火箭底部喷嘴高频振动。火箭箭体为提升载料效率,壳体设计轻薄,极易在持续振动中出现结构损伤,甚至存在解体风险。
二是高温回流烧蚀风险,尾焰温度高达3000K(约2700℃),多股火焰相互干涉后,部分高温气流会反向回流至喷嘴区域。这种回流位置、强度均无固定规律,呈现随机波动特性,无法通过常规手段预判烧蚀点位与损伤时间,只能依靠超大算力精细化仿真捕捉动态细节。
他进一步分析,在火箭回收优化研发中,AI超集群仿真具备实物试验无法替代的核心价值。传统火箭飞行试验仅能拍摄外部宏观状态,无法获取喷嘴内部的流场、温度、受力数据。同时,2700℃超高温、超高速的极端工况下,无任何传感器材料可稳定工作,无法实现内部数据采集,试验获取的有效数据极为有限。
依托曙光8000仿真,可完整还原三维精细化流场,精准捕捉喷流耦合、气流传递、热流分布、速度变化等全维度动态数据,可视化呈现极端工况下的细节变化。通过“有限试验数据+高精度仿真数据”的融合分析,可精准定位火箭结构、喷流布局的短板与隐患。这种仿真与试验互补的研发模式,能够快速迭代优化火箭设计方案,也是商业火箭实现快速更新升级、提升着陆回收安全性的核心技术支撑。
国产异构计算平台,支撑从算力到算法的仿真创新
从常态化仿真算力需求来看,常规工况仿真需要百亿级网格、上百卡算力规模,可实现多工况批量计算,可完成单工况结果输出,满足日常仿真迭代需求。但针对核心关键工况,为获取极致精细、精准的流场数据,就需要升级至万卡级超大规模算力。这也是突破并验证超大规模并行计算技术的核心意义,同时超大规模算力的深度调优,也能反向赋能常态化仿真任务,全面提升整体仿真效率与精度。
值得注意的是,流体仿真的精度并非仅依靠海量网格与超大算力实现。即便依托国产万卡算力支撑千亿、万亿级网格计算,若核心算法精度不足,仿真结果依旧会存在偏差,无法实现精准模拟。
因此,高精度前沿算法是提升仿真质量的核心关键,结合国产曙光8000异构计算平台,姬兴团队完成了底层算法的颠覆性革新。摒弃了目前学术界与工业界通用的龙格库塔时间推进方法,自主研发单步时空耦合高精度推进方法。全新算法在保障仿真精度不衰减的前提下,大幅降低计算耗时、提升运算效率。相较于传统算法,该方法对比两层龙格库塔算法,计算效率提升1倍;对比三层龙格库塔算法,效率提升可达3倍,实现了计算效率的倍数级突破,完美适配国产算力架构,兼顾了仿真精度与计算速度。
西安交通大学博士生张红表示,火箭33股尾焰存在超高速、2700℃(3000K)的极端工作环境,对仿真算法精度与硬件适配性提出极高要求。高精度流体算法适配各类硬件难度极大,相较于通用性强的CPU平台,异构计算平台架构适配需要结合算法特性逐一针对性优化。
本次仿真依托国产曙光8000,扩展至近10万张加速卡,但海量卡组并行带来了成倍增长的数据通信与数据搬运压力,传统多层龙格库塔时间推进算法已无法适配超大规模并行场景。传统业界选用多层算法,是因为单步法计算量大、算力需求高,而曙光加速卡具备独特硬件优势,可充分承接单步法的高算力需求,有效弥补平台带宽短板,最大化发挥硬件性能优势。
超大规模并行仿真的核心挑战并非计算量,而是通信瓶颈。算力拆分后,单卡计算任务缩减,但网格切面的通信数据量不会随拆分减少,卡数越多,跨卡通信压力越大。为此,团队依托单步算法优化,减少通信次数、隐藏数据传输时延。硬件算力单元充足但数据搬运带宽有限,新算法可实现批量数据预加载,让计算单元持续作业,在数据搬运的同时同步完成计算,彻底解决算力等待问题,高效适配国产十万级并行算力平台。
曙光8000的系统级优势
超大规模CFD计算流体力学高度依赖计算、通信、存储、调度的全系统协同联动,对AI超集群的综合性能、长时间运行的稳定性与运行效率有着极致要求。
中科曙光研发工程师梁超分析,该类计算具备极强的系统性关联特征,整体算力规模庞大、运行链路复杂,集群中任意一张加速卡、一个进程或链路出现故障,都会导致整体计算结果失效,单点问题会扩散为全局故障,因此稳定性是超大规模CFD仿真的核心前提。
网络通信是CFD计算的核心关键瓶颈。仿真程序在每一个时间步迭代中,都会产生海量的区域数据交互,对系统延迟、运行稳定性以及大规模MPI并行通信效率高度敏感。集群中若单个进程、单张加速卡运行卡顿,会直接拖累整体程序运行性能,引发全局性算力损耗。针对这一痛点,本次仿真采用经过深度优化的国产高速网络体系,针对高性能计算场景完成专项适配优化,经多轮应用测试验证,可充分满足超大规模CFD仿真的高频、海量通信需求,保障并行计算的通信稳定性与高效性。
存储与IO性能同样决定着仿真整体效率。CFD仿真全过程需要频繁加载初始数据,持续生成、读写海量中间结果与最终仿真数据,对IO传输的稳定性和速率要求极高。中科曙光团队深耕存储IO领域多年,积累了成熟的技术经验,通过针对性优化方案,有效保障了数据读写的稳定性与传输效率,规避了IO卡顿、数据异常等问题,为仿真持续稳定运行筑牢存储基础。
在资源调度层面,面对超大规模的节点与加速卡集群,灵活高效的调度体系必不可少。团队长期运维优化Slurm调度系统,该系统可精准适配海量算力节点的资源分配、任务调度需求,能够高效统筹超大规模并行计算任务,保障算力资源合理利用,适配超大工况的仿真运行需求。
同时,曙光团队搭建了完善的集群保障体系。依托数字孪生系统,可实现计算、网络、存储全链路可视化实时监测,精准掌握集群温度、设备连通性等核心状态,快速排查各类故障。系统原生支持故障链路自动切换,出现短暂链路波动时可快速自愈,不影响整体计算进程。此外,整套集群采用超规模化场景前置设计,提前规避各类运行风险,搭配专业运维与调优团队的多年技术积淀,全方位保障超大规模CFD仿真长期、稳定、高效运行。
曙光8000采用原生超智融合架构设计,可同时支撑高精度数值仿真与AI训练推理,为AI赋能科学计算(AI4S)奠定算力基础。本次高精度仿真成果不仅能够解析复杂流动机理,也可为后续智能算法研发提供高质量数据集。目前,该平台已适配300余项行业应用、覆盖30余个科研与产业领域。未来将持续推进算法、软件与算力平台的协同优化,持续支撑国家重大科研攻关与产业创新发展。
持续技术创新突破、赋能商业航天
此次研究围绕国产芯片的架构特点,协同优化高精度求解算法与异构并行框架,在超过8万张国产智能芯片上达到6.774万亿网格、99.01%弱扩展效率。该整体并行规模与弱扩展效率达到国内领先水平,标志着国产加速器平台上的高阶格式CFD软件首次进入十万卡级有效计算的行列。基于国产加速器构建完全自主的WENO-GKS高保真求解体系,填补了国产高性能计算多喷口超声速射流超大规模高精度模拟的空白。
姬兴表示,此次合作项目分为“研、算、致、用”四大发展阶段。目前底层算法研发、国产集群适配仿真软件开发的“研、算”阶段已完成里程碑突破,后续将持续迭代优化、完善功能。下一阶段将依托曙光8000 AI超集群,生成海量CFD仿真数据集,构建轻量化AI代理模型,实现流场高效快速预测。最终将技术落地应用于高速发展的商业航天产业,依托仿真技术降低研发试验成本。未来还可拓展应用至空天飞机等复杂飞行器气动、喷流场景,逐步实现技术商业化落地与产业化普及。
;}.c{fill:%23555;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='18'%20height='18'%20transform='translate(1543%202144)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20class='b'%20transform='translate(-1543%20-2144)'%3e%3cpath%20class='c'%20d='M182.144,108.918a.7.7,0,1,1-1.407,0V98.083l-.033.027-.054.05-5.045,5.045a.7.7,0,0,1-1.041-.945l.046-.05,5.045-5.045a2.508,2.508,0,0,1,3.477-.031l.075.072,4.988,5.022a.7.7,0,0,1-.949,1.038l-.05-.046L182.21,98.2l-.066-.061Zm5.394-15.827a.7.7,0,1,1,0,1.407h-12.2a.7.7,0,1,1,0-1.407Z'%20transform='translate(1370.601%202051.909)'/%3e%3c/g%3e%3c/svg%3e "回到顶部")