


'/%3e%3c/svg%3e) 发布
;}.c{fill:%233f3f3f;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='24'%20height='24'%20transform='translate(0%20-0.256)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20transform='translate(0%200.256)'%3e%3cg%20class='b'%3e%3cpath%20class='c'%20d='M12.938,13.58a.745.745,0,0,1-.328-.076L4.549,9.523a.741.741,0,0,1,0-1.33L12.61,4.212a.74.74,0,0,1,.657,0l8.061,3.981a.741.741,0,0,1,0,1.33L13.267,13.5a.741.741,0,0,1-.329.076M6.553,8.858l6.385,3.153,6.386-3.153L12.938,5.705Z'%20transform='translate(-1.067%20-1.067)'/%3e%3cpath%20class='c'%20d='M12.939,20.964a.729.729,0,0,1-.328-.077l-8.062-3.98a.742.742,0,1,1,.657-1.33l7.733,3.818,7.733-3.818a.742.742,0,1,1,.657,1.33l-8.062,3.98a.729.729,0,0,1-.328.077'%20transform='translate(-1.067%20-3.999)'/%3e%3cpath%20class='c'%20d='M12.939,26.964a.729.729,0,0,1-.328-.077l-8.062-3.98a.742.742,0,1,1,.657-1.33l7.733,3.818,7.733-3.818a.742.742,0,1,1,.657,1.33l-8.062,3.98a.729.729,0,0,1-.328.077'%20transform='translate(-1.067%20-5.547)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
;}.c{fill:%233f3f3f;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='24'%20height='24'%20transform='translate(0%200.225)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20transform='translate(0%20-0.225)'%3e%3cg%20class='b'%3e%3cpath%20class='c'%20d='M21.648,9.056a.754.754,0,0,0-.215-.535l-5.3-5.3a.752.752,0,0,0-.535-.215V3H7.375A2.377,2.377,0,0,0,5,5.376V20.307a2.377,2.377,0,0,0,2.375,2.376h11.9a2.378,2.378,0,0,0,2.376-2.376V9.056ZM16.355,5.584,19.07,8.3H16.923a.569.569,0,0,1-.568-.568Zm2.924,15.584H7.375a.862.862,0,0,1-.861-.861V5.376a.862.862,0,0,1,.861-.861h7.466V7.731a2.084,2.084,0,0,0,2.082,2.082H20.14V20.307a.863.863,0,0,1-.861.861'%20transform='translate(-1.215%20-0.729)'/%3e%3cpath%20class='c'%20d='M10.757,15.514H15.3A.757.757,0,0,0,15.3,14H10.757a.757.757,0,0,0,0,1.514'%20transform='translate(-2.43%20-3.402)'/%3e%3cpath%20class='c'%20d='M18.327,20h-7.57a.757.757,0,0,0,0,1.514h7.57a.757.757,0,0,0,0-1.514'%20transform='translate(-2.43%20-4.86)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)

;}.b,.c{fill:%233f96f0;stroke:%233f96f0;}.b{stroke-width:0.3px;}.c{stroke-width:0.2px;}%3c/style%3e%3c/defs%3e%3cg%20transform='translate(-2%20-2)'%3e%3crect%20class='a'%20width='16'%20height='16'%20transform='translate(2%202)'/%3e%3cg%20transform='translate(2%203)'%3e%3cpath%20class='b'%20d='M13.643,31H4.357c-.2,0-.357.224-.357.5s.16.5.357.5h9.286c.2,0,.357-.224.357-.5s-.16-.5-.357-.5'%20transform='translate(-1%20-18)'/%3e%3cpath%20class='c'%20d='M11.583,14.589l4.392-4.409a.415.415,0,0,0-.584-.586L12,13V4.416a.414.414,0,1,0-.828,0V13l-3.39-3.4a.415.415,0,1,0-.584.586Z'%20transform='translate(-3.562%20-3)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
;}.c{fill:%23dbdbdb;}.d{fill:none;stroke:%23333;stroke-linecap:round;stroke-linejoin:round;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='22'%20height='22'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20class='b'%3e%3cg%20transform='translate(1.375%202.251)'%3e%3cpath%20class='c'%20d='M7.563,9.224A20.661,20.661,0,0,1,18.8,8.265l-7.088,7.329-.922-.373-.023-3.312-1.389-.741-2.555.389-3.56,2.989-2,1.7s-.1-4.771,6.3-7.021'%20transform='translate(-0.5%200.249)'/%3e%3cpath%20class='d'%20d='M12.174.745l7.332,7.332a.834.834,0,0,1-.017,1.195L12.157,16.2a.833.833,0,0,1-1.405-.606V12.679a.844.844,0,0,0-.931-.832A11.108,11.108,0,0,0,2,16.74a.834.834,0,0,1-1.5-.576C1.132,9.59,3.786,5.4,9.942,5.066a.841.841,0,0,0,.81-.829v-2.9A.833.833,0,0,1,12.174.745Z'%20transform='translate(-0.5%20-0.5)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
基于RDX X5的3D桌宠
让角色、歌词与一句鼓励,成为办公桌上可以触碰的陪伴。
项目报告 · 2026 年 11 月修订
办公桌上的屏幕可以承载更多轻松的体验:一个安静活动的小角色,一段随音乐展开的歌词,或一句提醒自己放松的标语。本项目把这些内容放进三维场景,让用户用手势改变它们的位置与大小,给日常办公增加一点新意。
硬件采用 RDK X5 Module + MB,通过 MIPI 摄像头感知手部动作,BPU 完成手掌与关键点识别,raylib 负责呈现三维内容。角色、歌词和标语是三个独立场景,共享一套捏合、挥手和双手缩放的交互方式。
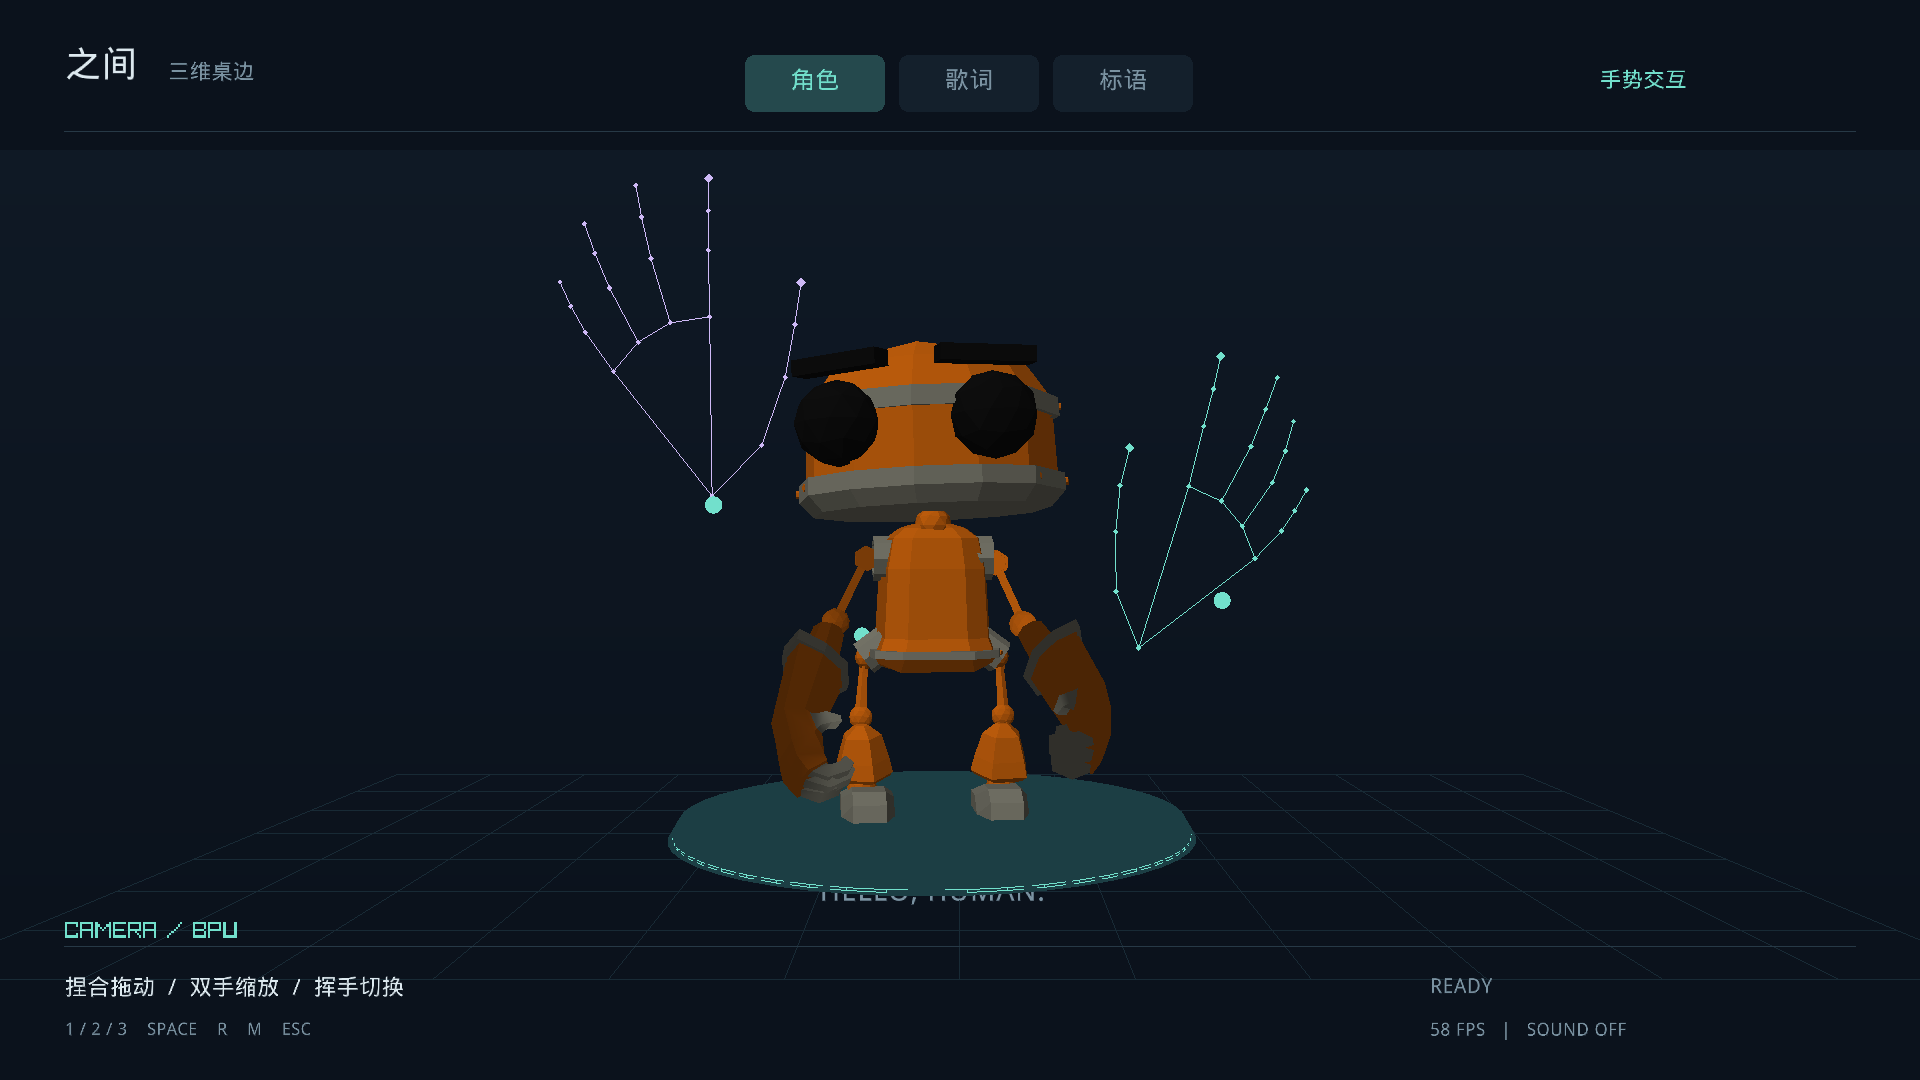
图 1|X5 实际运行画面。手部骨架来自实时摄像头与 BPU 输出,图中记录了双手交互。画面为板端 GPU 帧回读。
当前原型已经接通摄像头、识别与三维显示,真实输入触发过抓取和缩放。项目定位是具有手势交互的桌宠原型,尚未加入语音对话与大语言模型。
01 / 让操作接近日常动作
桌宠适合轻量、直观的操作。用户不需要记住菜单位置,手伸入画面,就能通过可见的骨架了解系统是否正在识别自己。
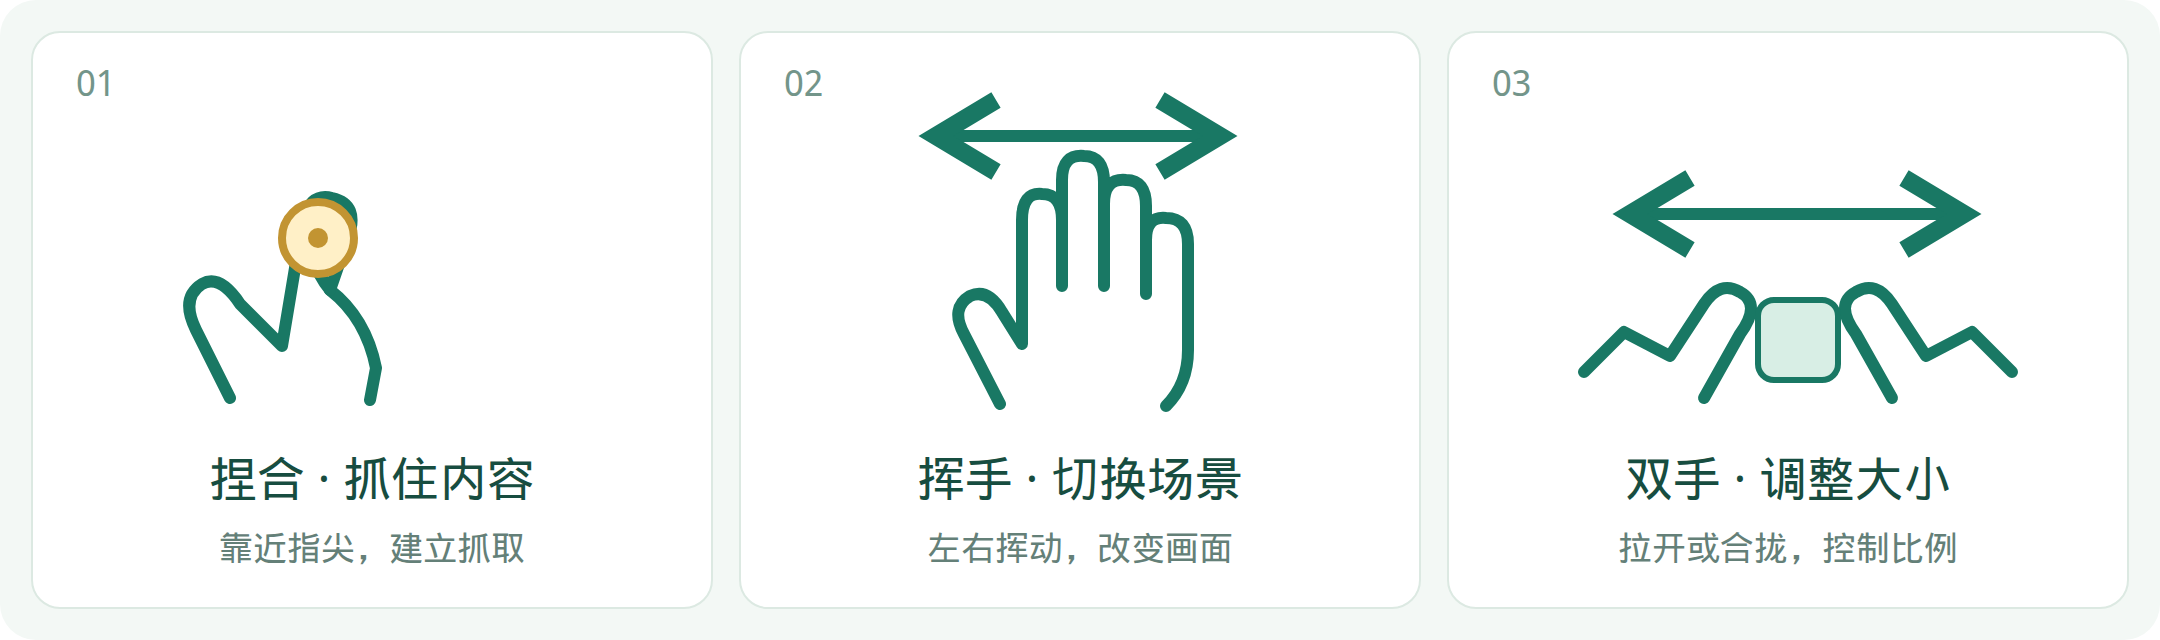
图 2|交互图示与图标方案。圆点强调指尖位置,箭头表示运动方向;图示用于表达操作逻辑。
手势 | 用户意图 | 内容反馈 |
|---|---|---|
捏住拇指与食指 | 抓住眼前的内容 | 骨架变为金色,整组内容跟随手部移动 |
张掌左右挥动 | 换一个画面 | 切换角色、歌词或标语场景 |
双手捏合并拉开、合拢 | 调整观看大小 | 内容随双手间距放大、缩小 |
交互的重点是连续感与确定感。镜像映射让画面中的移动方向接近用户直觉;坐标平滑减少细小抖动;短暂漏检得到有限容错;摄像头断流时释放内容,避免物体一直停留在被抓取的状态。
图标设计围绕“抓取、切换、缩放”三个动作展开,采用统一线宽、圆角和少量强调色。金色承担抓取反馈,方向箭头表达切换,向外与向内的箭头表达缩放。图标作为骨架和内容反馈的补充,帮助用户直观理解操作。
目前捏合连续性仍会受手掌角度和遮挡影响。挥手切换通过了模拟输入检查,真人触发还不够稳定;后续挥手改动尚需完成板端验证。真实抓取与缩放已有事件记录,尚未形成完整的真人手势成功率统计。
02 / 三种场景,三种桌边情绪
角色负责陪伴。 机器人以轻量的待机动画维持存在感,用户可以把它拖到喜欢的位置,也可以调整大小。角色选用 Quaternius 的 CC0 机器人资产,保留骨骼动画;简洁造型和纯色材质有利于控制绘制负担,也符合桌面摆件的视觉定位。
歌词负责节奏。 歌词进入三维空间,当前句成为视觉中心,前后句形成层次,逐字高亮和轻微波动让文字跟随音乐展开。界面把注意力留给文字,避免复杂控件抢走画面的情绪。
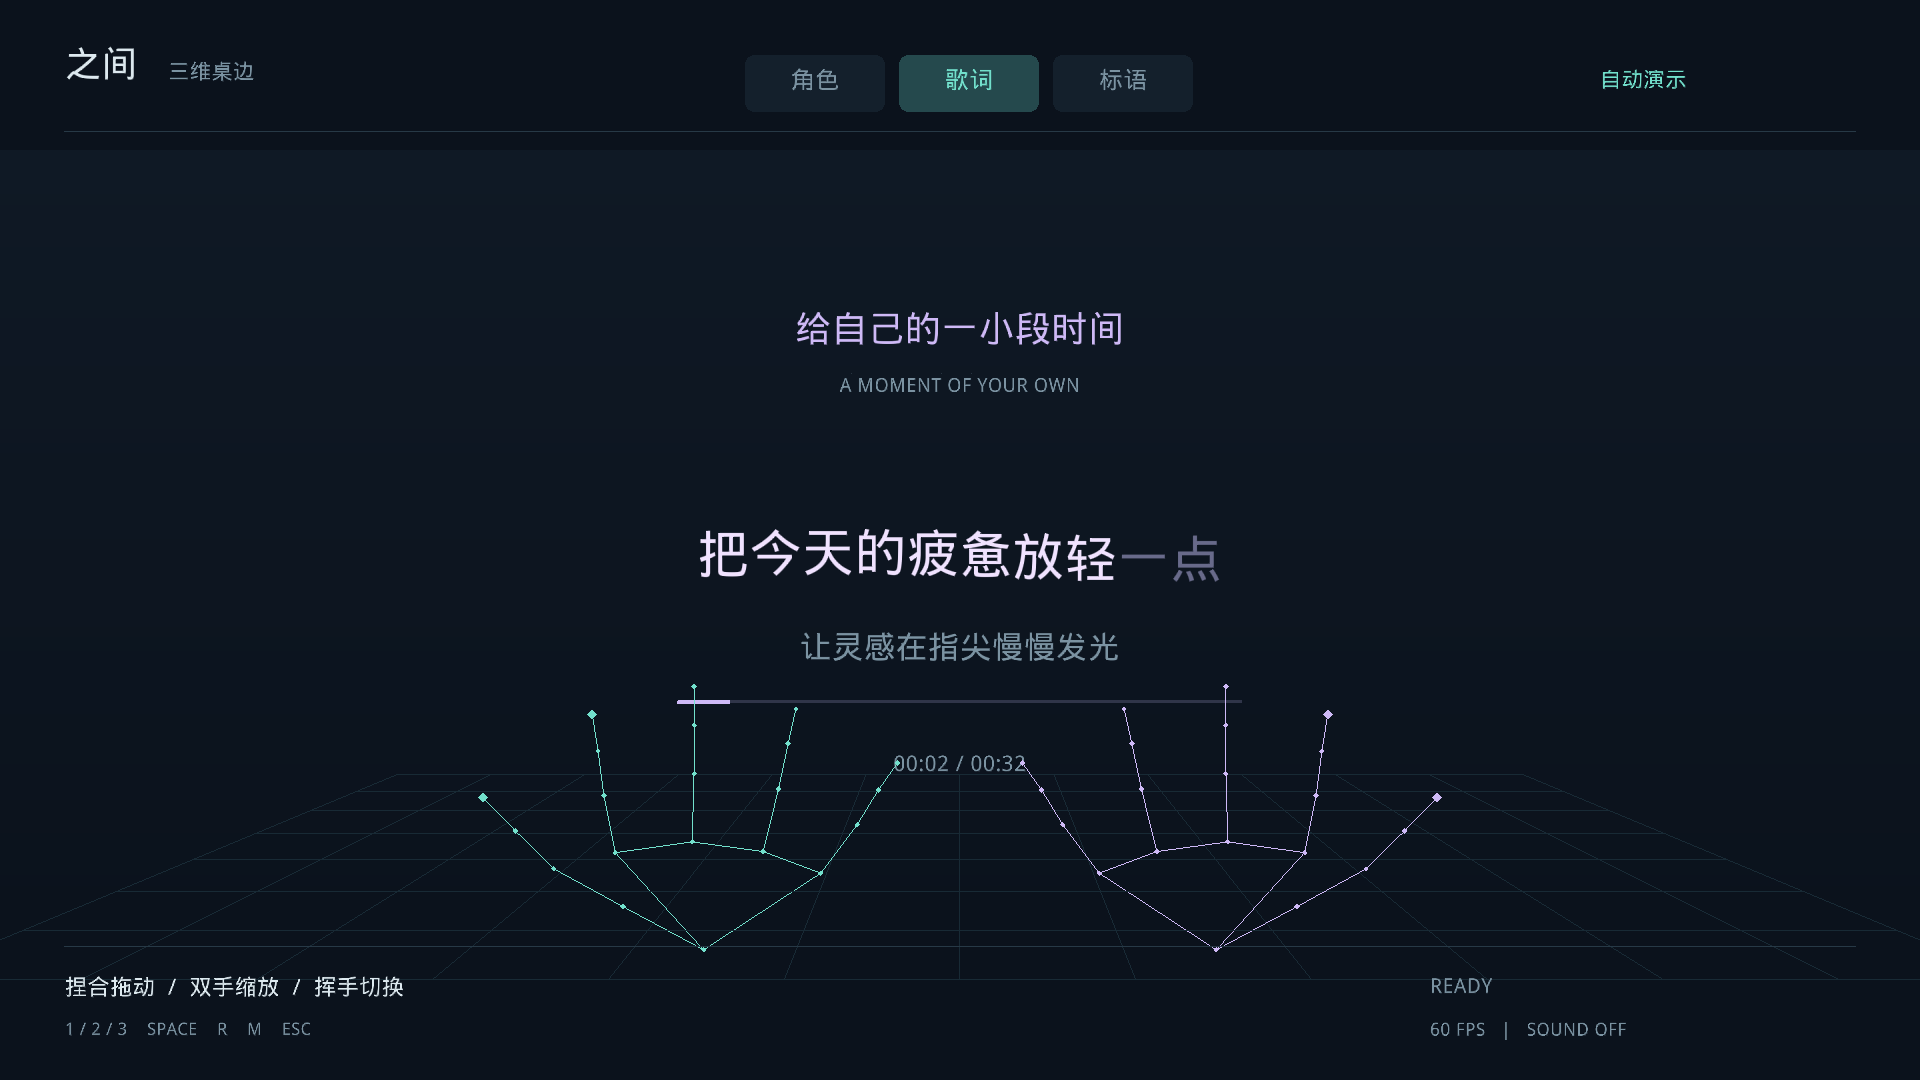
图 3|X5 上的歌词场景,1920×1080。图中骨架来自基准测试使用的模拟输入。
歌词采用适合动态文字的距离场字形,在清晰度和绘制成本之间取得平衡。每个字可以独立排列、运动和高亮,播放进度由音频时钟驱动,减少画面与音乐脱节的感觉。
当前示例使用原创合成器乐与示例歌词,逐字高亮按行时长分配,尚未实现真实演唱的逐字时间对齐。这里的重点是空间排布、节奏反馈与手势控制所形成的观看体验。
03 / 让一句标语拥有体积
标语负责表达。 相比持续变化的歌词,短句适合成为一个可以摆放、移动和放大的三维对象。“今天也辛苦了”这类内容,不只是一条通知,也可以是桌边温和的情绪提示。
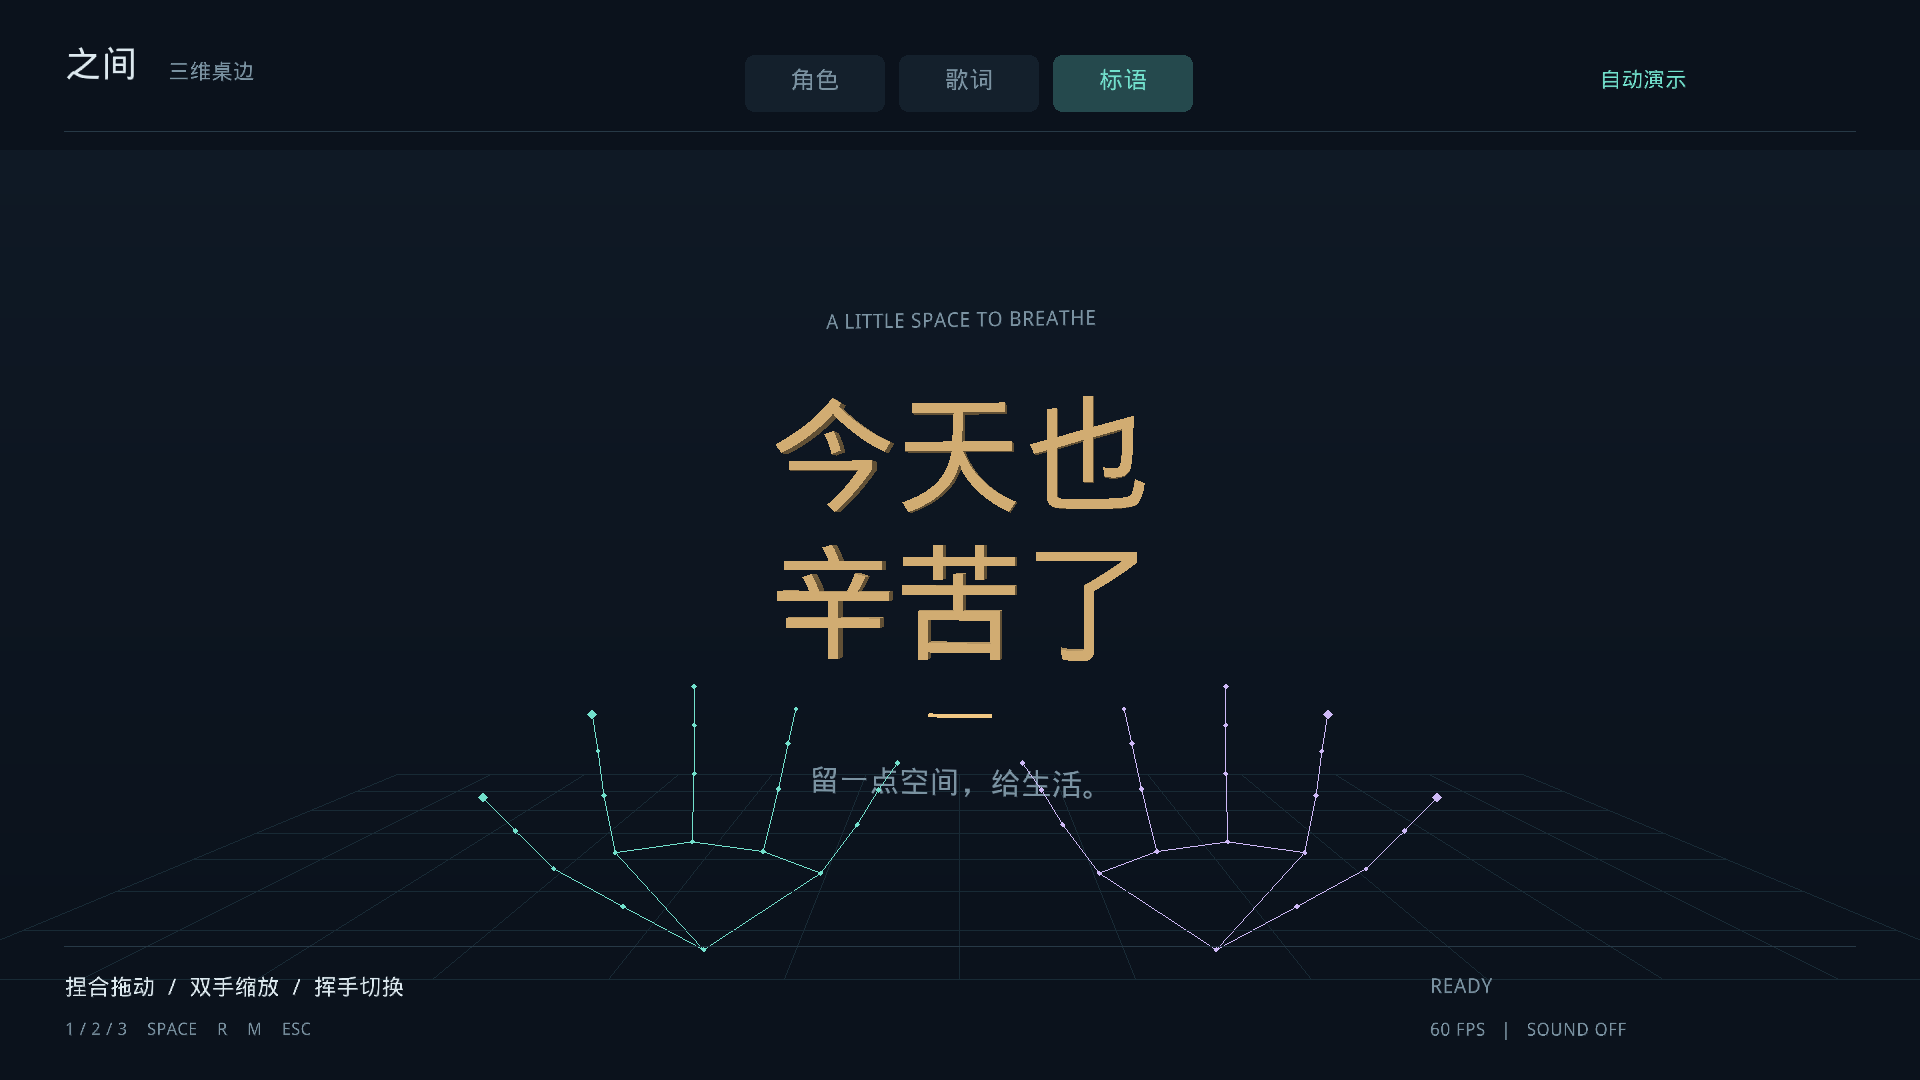
图 4|X5 上的立体标语。字形具有正面、侧面和厚度,图中骨架来自模拟输入。
标语使用字体轮廓生成三维网格,侧面的明暗变化让文字具有实体感。复杂的字形处理在开发端完成,X5 负责加载、绘制与交互,减少设备运行时的额外负担。
视觉内容 | 设计重点 | 表现方式 |
|---|---|---|
角色 | 陪伴感与生命感 | 骨骼动画、简洁材质、整体拖动 |
歌词 | 阅读节奏与空间层次 | 距离场字形、前后句排布、逐字高亮 |
标语 | 体积感与情绪表达 | 立体字形、侧面明暗、整组缩放 |
三个场景使用同一套操作习惯,让用户切换内容时不必重新学习。当前抓取与缩放针对整组内容,新增标语需要重新生成资产;逐字抓取和任意长文实时建模不属于当前原型范围。
04 / X5 把感知与显示连接起来
最终方案采用 MIPI 摄像头 + BPU 手部识别 + raylib 三维显示。视觉识别与画面绘制独立运行,识别结果更新手部状态,显示端持续绘制角色、文字和骨架,让识别节奏与显示节奏相互解耦。
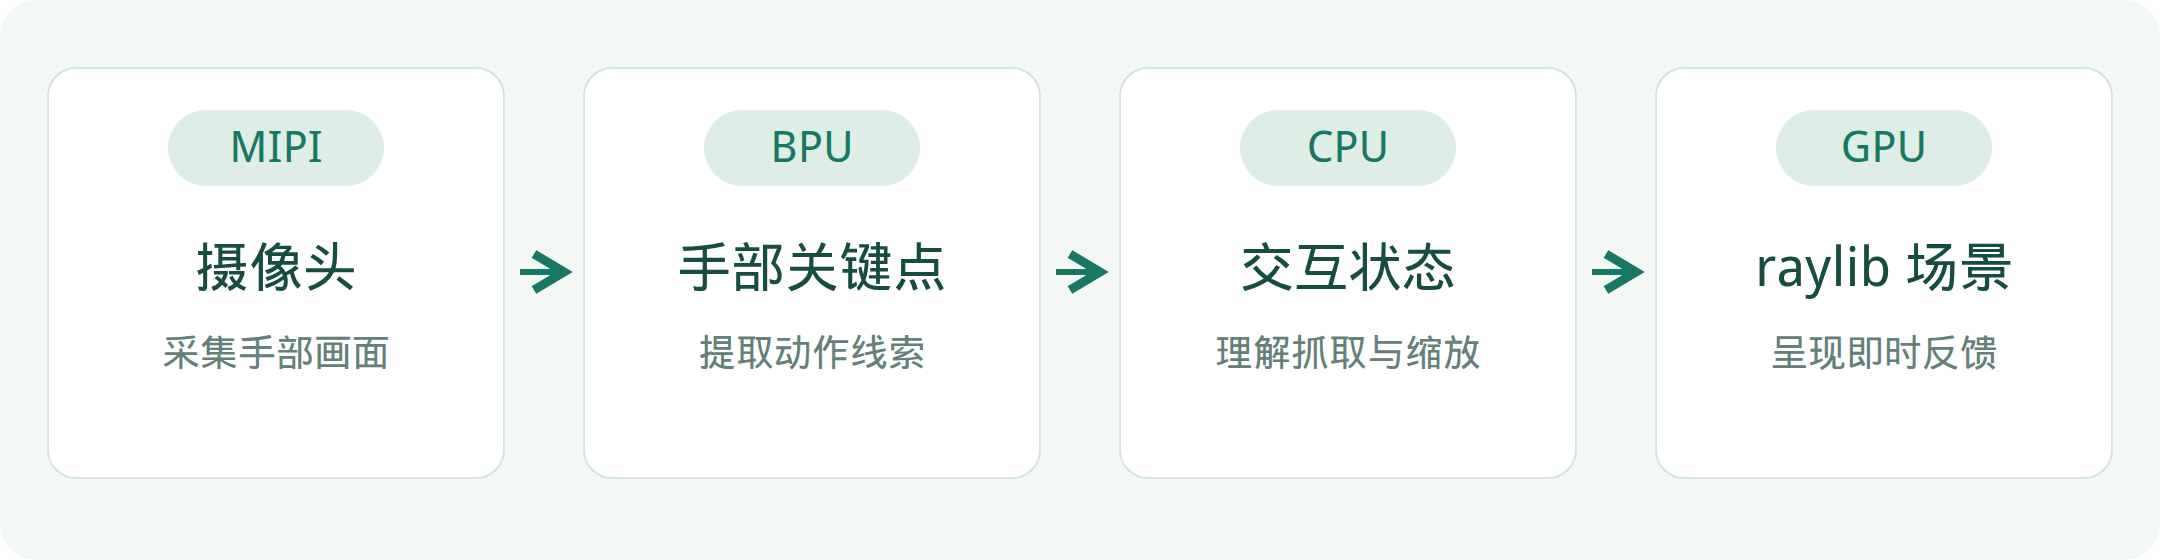
图 5|最终方案的主线。摄像头提供图像,BPU 提取关键点,交互层理解动作,GPU 呈现反馈。
平台能力 | 项目中的实际用途 |
|---|---|
MIPI 与图像处理链路 | 获取手部画面,适配安装方向与图像格式 |
BPU | 运行 MediaPipe 系列手掌检测与 21 点手部关键点模型 |
CPU | 跟踪手部、平滑坐标、判断手势并传递交互状态 |
GPU 与 HDMI | 绘制角色、空间文字和骨架,输出原生 1080p 画面 |
平台适配集中在三个方面:让应用使用厂商 GPU 加速路径,让相机输出正确进入模型,让关键点稳定映射到屏幕空间。画面比例、镜像方向和抓取反馈共同决定“手能否自然地控制内容”,它们与模型识别同样重要。
开发端使用 WSL 处理资产、整理记录与模拟关键点;X5 承担相机、BPU 和实际显示验证。相同的交互入口也支持历史数据回放,便于复现不连续的动作。
双目硬件已接入,立体测距尚未使用。 左右两路采集已经跑通,当前交互只选择一路图像,在同一画面中识别最多两只手。骨架的相对深度来自模型估计,交互仍基于图像平面,尚不能测量手到屏幕的真实距离。
05 / 技术取舍服务于观看体验
项目选择 raylib,是因为三种场景的规模明确,轻量的绘制与内容管理更适合当前原型。角色网格与材质提交经过整理,歌词与标语也分别采用适合自身特点的表现方式,使 X5 的资源更多用于画面与交互。
备选路线 | 本项目中的取舍 |
|---|---|
Godot | 已跑通硬件加速;完整 1080p 原型的帧率未达到目标,因此转向更轻量的实现 |
Qt Quick | 已验证中文与动画输出;最终使用 raylib 统一三维场景,未继续扩展 |
Vulkan 路径 | 当时的显示呈现链路未打通,未作为交付方案 |
默认桌面渲染路径 | 曾落入 CPU 软件渲染,改用确认过的 GPU 加速路径 |
原生 1920×1080、保留动画与模拟手骨架的 30 秒显示基准中,角色平均 58.33 FPS,歌词 55.50 FPS,标语 54.63 FPS。这些结果接近流畅展示的目标,但仍存在较长帧,不能写成稳定锁定 60 FPS。
观察项 | 实测结果 | 对体验的意义 |
|---|---|---|
三场景显示基准 | 平均约 55–58 FPS | 轻量角色和三维文字具备流畅展示的基础 |
真实视觉输出 | 约 28–29 FPS | 手部识别能够持续为交互提供状态更新 |
角色与识别并行 | 一轮未主动截图的显示状态采样为 55–60 FPS | 感知与显示已能共同运行,仍需完整帧时间验证 |
散热 | 曾接近 95°C,并出现 DDR 热限频 | 持续体验需要完善散热与长时间测试 |
显示基准未并行运行相机与 BPU;并行数据来自角色场景,两组结果的条件不同。与历史 Godot 原型相比,raylib 方案的画面流畅度明显改善,但场景实现也经过优化,不能将差异完全归因于引擎。
06 / 对 X5 平台的评价
这次实践中,X5 值得肯定的地方,是能够在一块板上完成从手部感知到三维反馈的完整交互闭环。摄像头获取画面,BPU 提取手部关键点,GPU 呈现角色与文字,用户的动作因此能够在桌边得到直接回应。
历史路线也说明了平台的可拓展性。Godot 与 Qt Quick 都曾实现硬件输出,最终选择 raylib 是针对本项目内容规模和帧率目标的取舍。X5 为多种应用组织方式提供了基础;厂商相机链路与模型移植资源,也让项目能够把更多精力投入交互与视觉表达。
与此同时,图形驱动与应用的匹配仍需要工程适配,复杂场景的提交开销、手势连续性和高温下的持续表现也不能忽略。这些边界决定了它更适合从目标清晰的轻量应用切入,通过内容设计与负载优化形成稳定体验。
对于一款强调陪伴感、空间文字和自然手势的桌面原型,X5 已展现出有说服力的综合能力:它既能承担实际的视觉识别,也能驱动原生 1080p 三维画面,让“桌宠”从屏幕动画走向能够感知用户动作的交互装置。
项目后续的重点是提升捏合与挥手的稳定性、完善状态图标与视觉反馈,以及验证散热改善后的持续运行表现。真实双目深度则面向更进一步的空间交互:让用户不仅能拖动内容,也能通过前后伸手改变内容的距离。
项目资料: raylib 显示实测、相机与 raylib 联动、手势验证记录、图形平台验证。
开源与资产: 显示采用 raylib,视觉采用 D-Robotics 移植的 MediaPipe 系列模型;机器人资产为 CC0,字体采用文泉驿。相应许可与模型来源保留在项目中。
;}.c{fill:%23555;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='18'%20height='18'%20transform='translate(1543%202144)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20class='b'%20transform='translate(-1543%20-2144)'%3e%3cpath%20class='c'%20d='M182.144,108.918a.7.7,0,1,1-1.407,0V98.083l-.033.027-.054.05-5.045,5.045a.7.7,0,0,1-1.041-.945l.046-.05,5.045-5.045a2.508,2.508,0,0,1,3.477-.031l.075.072,4.988,5.022a.7.7,0,0,1-.949,1.038l-.05-.046L182.21,98.2l-.066-.061Zm5.394-15.827a.7.7,0,1,1,0,1.407h-12.2a.7.7,0,1,1,0-1.407Z'%20transform='translate(1370.601%202051.909)'/%3e%3c/g%3e%3c/svg%3e "回到顶部")