


'/%3e%3c/svg%3e) 发布
;}.c{fill:%233f3f3f;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='24'%20height='24'%20transform='translate(0%20-0.256)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20transform='translate(0%200.256)'%3e%3cg%20class='b'%3e%3cpath%20class='c'%20d='M12.938,13.58a.745.745,0,0,1-.328-.076L4.549,9.523a.741.741,0,0,1,0-1.33L12.61,4.212a.74.74,0,0,1,.657,0l8.061,3.981a.741.741,0,0,1,0,1.33L13.267,13.5a.741.741,0,0,1-.329.076M6.553,8.858l6.385,3.153,6.386-3.153L12.938,5.705Z'%20transform='translate(-1.067%20-1.067)'/%3e%3cpath%20class='c'%20d='M12.939,20.964a.729.729,0,0,1-.328-.077l-8.062-3.98a.742.742,0,1,1,.657-1.33l7.733,3.818,7.733-3.818a.742.742,0,1,1,.657,1.33l-8.062,3.98a.729.729,0,0,1-.328.077'%20transform='translate(-1.067%20-3.999)'/%3e%3cpath%20class='c'%20d='M12.939,26.964a.729.729,0,0,1-.328-.077l-8.062-3.98a.742.742,0,1,1,.657-1.33l7.733,3.818,7.733-3.818a.742.742,0,1,1,.657,1.33l-8.062,3.98a.729.729,0,0,1-.328.077'%20transform='translate(-1.067%20-5.547)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
;}.c{fill:%233f3f3f;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='24'%20height='24'%20transform='translate(0%200.225)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20transform='translate(0%20-0.225)'%3e%3cg%20class='b'%3e%3cpath%20class='c'%20d='M21.648,9.056a.754.754,0,0,0-.215-.535l-5.3-5.3a.752.752,0,0,0-.535-.215V3H7.375A2.377,2.377,0,0,0,5,5.376V20.307a2.377,2.377,0,0,0,2.375,2.376h11.9a2.378,2.378,0,0,0,2.376-2.376V9.056ZM16.355,5.584,19.07,8.3H16.923a.569.569,0,0,1-.568-.568Zm2.924,15.584H7.375a.862.862,0,0,1-.861-.861V5.376a.862.862,0,0,1,.861-.861h7.466V7.731a2.084,2.084,0,0,0,2.082,2.082H20.14V20.307a.863.863,0,0,1-.861.861'%20transform='translate(-1.215%20-0.729)'/%3e%3cpath%20class='c'%20d='M10.757,15.514H15.3A.757.757,0,0,0,15.3,14H10.757a.757.757,0,0,0,0,1.514'%20transform='translate(-2.43%20-3.402)'/%3e%3cpath%20class='c'%20d='M18.327,20h-7.57a.757.757,0,0,0,0,1.514h7.57a.757.757,0,0,0,0-1.514'%20transform='translate(-2.43%20-4.86)'/%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
;}.cls-3{fill:%23dbdbdb;}.cls-4{stroke:%23333;stroke-miterlimit:10;stroke-width:0.5px;}%3c/style%3e%3cclipPath%20id='clip-path'%3e%3crect%20class='cls-1'%20width='22'%20height='22'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20class='cls-2'%3e%3cpath%20class='cls-3'%20d='M16.89,7.8s-1,4.28-4,6a21,21,0,0,1-6.55,1.66,9.87,9.87,0,0,0,6.38,1c3.47-.72,6.82-4.66,6.71-5.43A5.88,5.88,0,0,0,17.6,8.17,2.76,2.76,0,0,0,16.89,7.8Z'/%3e%3cellipse%20class='cls-4'%20cx='11'%20cy='10.94'%20rx='8.53'%20ry='5.49'/%3e%3ccircle%20class='cls-4'%20cx='11'%20cy='10.94'%20r='2.49'/%3e%3c/g%3e%3c/svg%3e)
10月13日,在上海举办的工博会上,爱芯元智正式发布了AX8660大算力芯片产品,爱芯元智确立“现场智能”四大要素。凭借原生FP4、高带宽及多芯级联技术,解决边缘大模型部署瓶颈,提供从模组到整机的全场景算力底座,推动AI向物理世界下沉。
爱芯元智创始人兼董事长仇肖莘表示:“AI最初建立在云端训练,下一站是什么?一定是物理AI,提供‘现场智能’,即指事件发生的现场,能够准确捕捉到这个事件,同时能够根据周围的环境,发生的事件做现场的判断。根据判断去指挥各种的设备或机器执行。现场智能有四大关键要素:一、看得见;二、算得准,支持大参数模型以避免小模型幻觉,确保关键操作准确;三、反应快,毫秒级甚至更短时间内完成决策,满足严苛延时要求。智能汽车、无人机、机器人这些场景需要决策快;四、稳执行,决策链路稳定可持续,支持长时间连续操作。”
AX8660构建三大优势,支持FP4,为边缘A推理I而生
边缘设备跑大模型,卡脖子往往不是算力,而是显存、内存带宽和功耗。FP4同时把这4个压下来。支持FP4方案本质上意味着用精度换效率的极致推理方案,70B模型参数显存需求从FP16的140GB下降到FP4的35GB,单卡即可加载,推理延迟大幅度降低。
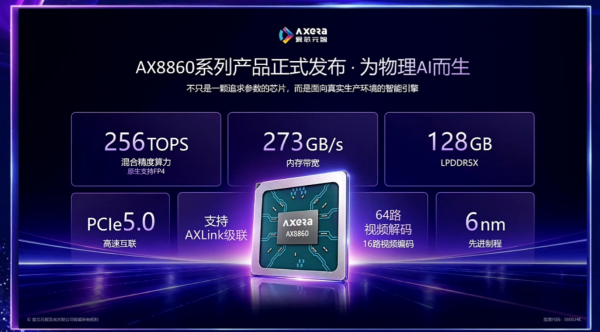
爱芯元智正式推出AX8860系列芯片(包括AX8860P和AX8860),专为物理AI打造,具备三大核心优势:
一、极致性能和精度支持:
AX8860峰值算力达到256Tops,采用混合精度设计,支持原生FP4精度的芯片。这颗芯片除了支持INT4、INT8、INT16、FP8、FP16之外,又支持原生FP4。
高内存带宽:内存带宽达到273GB/s,与国际领先GPU相当,与256T算力形成良好匹配,消除瓶颈。
二、大模型承载能力
大容量显存:单芯片支持128GB LPDDR5x内存,可支持数百亿参数模型,大幅减少推理幻觉。
多芯级联技术:支持基于AxLink接口的Chip-to-Chip互联,可实现双芯或四芯级联。四芯级联后内存池化可达512GB,足以支持千亿参数以上的大模型(如DeepSeek-V2 Flash等) 。
级联效率:多芯级联效率维持在80%左右,高于行业平均水平,确保1+1>2的算力扩展效果。
三、能效比优势:
先进制程:采用6nm工艺,功耗控制优异。
低功耗表现:满负载功耗仅为国际竞品GPU的45%-50%,典型功耗约20-30W,最大功耗约50W,适用于散热受限的边缘场景。
爱芯元智披露,AX8860P芯片 prefill阶段首Token的响应速度,还是Decode阶段持续生成速度的速度已经至少打平了国际大厂的GPU,AI推理性能均衡,可以把芯片能力发挥到极致。满负载的功耗是竞品的50%以下。
值得关注的是,A8860X工具链又进行了进一步的提升,它兼容了主流的推理框架,AX8860配套工具链支持vLLM、SGLang、PyTorch等主流框架与开发环境,并提供兼容OpenAI API的服务接口,覆盖模型量化、转换、编译和调试等流程。
推出高性能边缘AI模组,加速客户新品上市
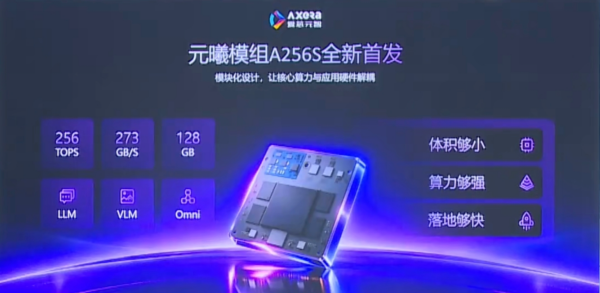
仇肖莘介绍,爱芯元智推出了A256S核心模组,该模组集成AX8860及4颗LPDDR5内存,体积小巧,我们希望通过核心板落地,便于客户快速集成至主板。
爱芯元智还展示了元曦系列的Agent Box、推理卡和推理服务器,比如合作伙伴打造的4芯级联的PCle卡,支持1000TOPS算力及512GB内存,单卡即可运行千亿参数大模型。
我们AX8860还可以做成4卡或者8卡的一体机,就能够让许多原来只能跑在云端的推理能够在边缘侧跑起来。现场展示的内置核心模组的智能体盒子,兼具充电功能;紧凑型体积约为国际竞品一半。
爱芯元智此次展示的芯片、模组、推理卡、软件工具链与合作伙伴演示形成了系列化的产品链条,让客户看到算力如何协同算法靠近具体任务。
;}.c{fill:%23555;}%3c/style%3e%3cclipPath%20id='a'%3e%3crect%20class='a'%20width='18'%20height='18'%20transform='translate(1543%202144)'/%3e%3c/clipPath%3e%3c/defs%3e%3cg%20class='b'%20transform='translate(-1543%20-2144)'%3e%3cpath%20class='c'%20d='M182.144,108.918a.7.7,0,1,1-1.407,0V98.083l-.033.027-.054.05-5.045,5.045a.7.7,0,0,1-1.041-.945l.046-.05,5.045-5.045a2.508,2.508,0,0,1,3.477-.031l.075.072,4.988,5.022a.7.7,0,0,1-.949,1.038l-.05-.046L182.21,98.2l-.066-.061Zm5.394-15.827a.7.7,0,1,1,0,1.407h-12.2a.7.7,0,1,1,0-1.407Z'%20transform='translate(1370.601%202051.909)'/%3e%3c/g%3e%3c/svg%3e "回到顶部")